הרבה מוצרים מוסיפים היום כפתור "שאלו את ה-AI" או חלון צ'אט, וקוראים לעצמם מוצר AI. בדמו זה עובד, אבל אחרי ההשקה מתגלים הפערים: הנתונים לא נשמרו בצורה שמודל יכול להשתמש בה, הממשק לא יודע להציג תשובה שאולי שגויה, והחשבון של ספק המודל גדל בלי שמישהו יודע איזו פעולה אחראית לו. מוצר AI-Native נבנה אחרת: ה-AI מבצע חלק מהעבודה המרכזית של המוצר, ולכן הארכיטקטורה, הנתונים והממשק מתוכננים סביבו כבר מההתחלה. המדריך הזה מיועד למייסדים, ל-CTO ולמנהלי מוצר שמתכננים אפליקציה או SaaS, ומפרט מה כדאי להחליט לפני שכותבים את השורה הראשונה, ומה אפשר לדחות.
מה זה מוצר AI-Native
ההגדרה השימושית ביותר היא מבחן פשוט: מה קורה למוצר אם מכבים את המודל? אם המשתמש עדיין מקבל את הערך המרכזי, רק בלי קיצור דרך, ה-AI הוא תוספת. אם הפעולה המרכזית כבר לא מתבצעת, המוצר AI-Native.
דוגמה: מערכת לניהול חשבוניות עם כפתור "סכמו לי את החשבונית" היא מוצר רגיל עם פיצ'ר AI. מערכת שבה החשבונית נקלטת, המודל מחלץ ממנה ספק, סכום ושורות, משייך אותה להזמנה ומעביר לבדיקה של אדם רק את מה שלא תאם, בנויה סביב ה-AI. בלי המודל אין תהליך. כך נראה למשל עיבוד מסמכים חכם עם AI.
פיצ'ר משני, כמו צ'אט או כפתור "צור טקסט", מעל מסכים ונתונים שתוכננו בלעדיו. אין משוב מובנה על התוצאות, והעלות נמדדת רק בחשבונית החודשית של ספק המודל.
המודל מבצע חלק מהפעולה המרכזית. הנתונים נשמרים כדי לתת לו הקשר, הממשק בנוי לתוצאה שצריך לבדוק, וכל תהליך נמדד באיכות ובעלות.
וחשוב לומר: לא כל מוצר צריך להיות AI-Native. אם הערך של המוצר הוא ניהול מלאי פשוט או טופס הרשמה, תוספת AI קטנה במקום הנכון יכולה להספיק. המדריך הזה רלוונטי כשה-AI אמור לבצע עבודה שהמשתמש עשה קודם בעצמו.
חמש השכבות של מוצר AI-Native
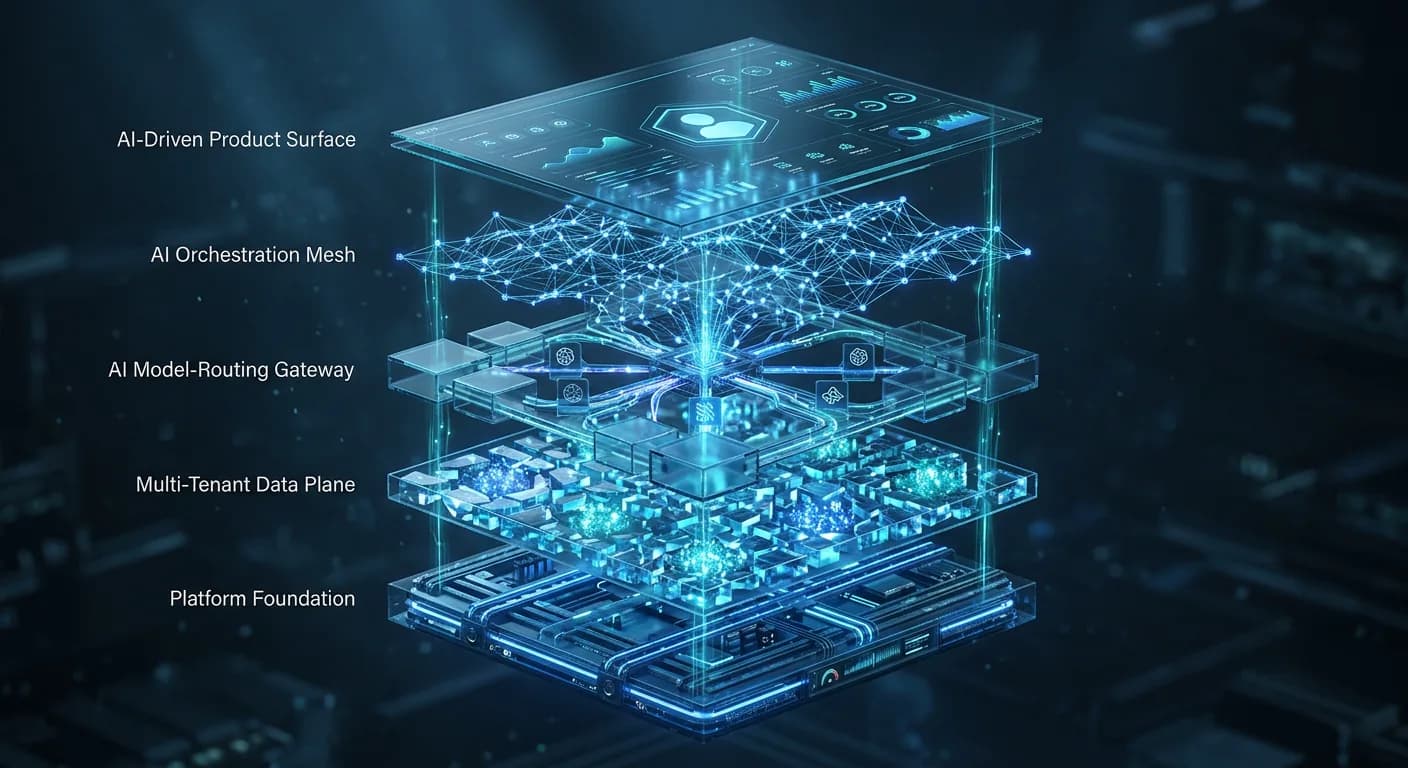
בכל מוצר כזה, אפליקציה או SaaS, חוזרות אותן חמש שכבות. ב-MVP הן לא חייבות להיות שירותים נפרדים, אבל כדאי שיהיו ביניהן גבולות ברורים בקוד, כדי שאפשר יהיה להחליף מודל, להוסיף לקוח או לשנות תהליך בלי לכתוב הכל מחדש.
משטח המוצר
המסכים וה-API שהמשתמש פוגש. פעולה כאן מפעילה תהליך: שליפת הקשר, קריאה למודל, הפעלת כלי והחזרת תוצאה. הלוגיקה העסקית לא יושבת בממשק.
תזמור
המקום שבו מוגדרים התהליכים: ההנחיות למודל (פרומפטים) עם גרסאות, הכלים שהמודל רשאי להפעיל, ניסיונות חוזרים, וכללים מתי לעצור ולהעביר לאדם.
ניתוב מודלים
נקודה אחת שדרכה עוברות כל הקריאות למודלים. היא בוחרת מודל לפי סוג המשימה, אורך ההקשר וזמן התגובה הנדרש, ורושמת את העלות של כל קריאה. כך מחליפים ספק בלי לגעת בכל המוצר.
נתונים והקשר לכל לקוח
המסמכים, האירועים וההיסטוריה שמהם המודל שולף הקשר (RAG), מופרדים לפי לקוח ולפי הרשאות. כל שליפה עולה כסף ויכולה לחשוף מידע, ולכן גם היא מתוכננת.
פלטפורמה
הרשאות, מכסות שימוש לכל לקוח, בדיקות איכות, ניטור ומדידת עלות לכל תהליך. בלי השכבה הזאת המערכת נראית תקינה, והבעיות מתגלות בחשבונית או בתלונה של לקוח.
כשהתזמור כולל סוכן שמפעיל כלים בעצמו, כמו עדכון CRM או שליחת הודעה, ההבדל בינו לבין צ'אטבוט שרק עונה הוא גם הבדל בארכיטקטורה. פירטנו אותו במדריך סוכני AI לעסקים: מה הם באמת יכולים לעשות.
נתונים: מה שומרים מהיום הראשון
מודל טוב לא יעזור אם אין לו הקשר. לכן כבר ב-MVP כדאי לשמור, בצורה מסודרת, את מה שהמודל יצטרך בהמשך: פעולות של משתמשים, מסמכים שהם העלו, החלטות שהתקבלו, ובעיקר את התגובה שלהם לתוצאה של המודל. כשמשתמש מאשר, מתקן או דוחה תוצאה, זה הסיגנל החשוב ביותר שיש לכם לשיפור המוצר.
ב-SaaS שמשרת כמה לקוחות על אותה תשתית (multi-tenant), גם הזיכרון של ה-AI צריך הפרדה: אינדקס החיפוש, היסטוריית השיחות וכל הקשר שנשמר לסוכן שייכים ללקוח אחד ולא זולגים לאחר. איך בוחרים בין מודלי ההפרדה Pool, Silo ו-Bridge, ומה כל אחד מהם עושה לעלות לכל לקוח, פירטנו במדריך ארכיטקטורת Multi-Tenant ל-SaaS (באנגלית).
במוצר שמחזיק מידע אישי של ישראלים יש לזה גם צד משפטי. תיקון 13 לחוק הגנת הפרטיות, שנכנס לתוקף ב-14 באוגוסט 2025, הרחיב את החובות של מי שמחזיק מאגרי מידע אישי. בפועל זה אומר להחליט מראש איזה מידע נשלח למודל, אצל איזה ספק הוא מעובד ומי יכול לגשת אליו. קל הרבה יותר לתכנן את זה מראש מאשר להוסיף אחרי שהנתונים כבר זורמים.
UX לתוצאה שלא תמיד נכונה
ממשק רגיל מניח שהמערכת תמיד צודקת. מודל שפה טועה לפעמים, ולכן הממשק של מוצר AI-Native צריך לעזור למשתמש לבדוק את התוצאה מהר. כמה עקרונות שחוזרים:
- להראות על מה התשובה מבוססת. מקור, מסמך או שורה בנתונים, כדי שהמשתמש יוכל לבדוק בלי לחפש.
- לאפשר עריכה, לא רק אישור או דחייה. תיקון קטן של המשתמש חוסך לו עבודה, ונותן לכם סיגנל לשיפור.
- להגדיר מתי אדם מאשר. פעולות שנוגעות בכסף, בלקוחות או במידע רגיש עוברות אישור, לפחות בהתחלה.
- להציג את מה שקורה בדרך. שלב שבו המודל מחפש, מפעיל כלי או נכשל באמצע הוא חלק מהזרימה, ולא צריך להסתתר מאחורי ספינר כללי.
ונקודה אחת שקל לפספס: מתחילים מהפעולה שהמודל אמור לבצע, לא מהדשבורד. אם המסך הראשון הוא דשבורד מוכר עם חלון צ'אט בצד, כנראה שה-AI עדיין תוספת.
אותם עקרונות חלים באפליקציות מובייל, עם שאלה נוספת: מה רץ על המכשיר ומה בשרת. בעמוד פיתוח אפליקציות לאייפון ולאנדרואיד פירטנו איך אנחנו בונים אפליקציות עם AI, כולל AI שרץ על המכשיר עצמו.
איכות ועלות נמדדות לכל תהליך
במוצר רגיל, אם השרת עונה, הכל בסדר. במוצר AI-Native השרת יכול לענות מהר ועדיין להחזיר תוצאה גרועה, או תוצאה טובה שעולה יותר ממה שהלקוח משלם. לכן מודדים שני דברים מהיום הראשון.
איכות. אוסף קבוע של דוגמאות אמיתיות עם התוצאה הנכונה לכל אחת, שרץ אוטומטית בכל פעם שמשנים הנחיה, מודל או תהליך. בלי זה אין דרך לדעת אם שינוי שיפר או קלקל. במוצר בעברית זה חשוב במיוחד: צריך לבדוק ניסוחים, שגיאות כתיב ומונחים מהתחום של המשתמשים.
עלות לתוצאה. לא רק כמה שילמתם לספק המודל החודש, אלא כמה עולה תהליך אחד שהסתיים בהצלחה, ואיזה לקוח או פיצ'ר צורך הכי הרבה. כאן נכנס ניתוב המודלים: משימות פשוטות כמו סיווג וחילוץ שדות יכולות לרוץ על מודל קטן וזול, ומודל חזק נשמר למשימות שבאמת צריכות אותו. את הנוסחה לחישוב עלות השימוש במודל פירטנו במדריך כמה עולה סוכן AI לעסק.
לסוכנים שמפעילים כלים בעצמם צריך גם תקרה: מספר צעדים מרבי, מספר קריאות לכלים וגודל הקשר מרבי לכל תהליך ולכל לקוח. סוכן בלי תקרה יכול להיתקע בלולאה, והחשבון מגיע רק בסוף החודש.
ההחלטות של היום הראשון
רוב ההחלטות האלה לא דורשות לבנות הכל מראש. הן דורשות להחליט איפה יעבור הגבול, כדי שאפשר יהיה להרחיב בלי לכתוב מחדש.
| החלטה | מה מספיק ב-MVP | מתי משדרגים |
|---|---|---|
| תזמור | תהליכים בקוד של המוצר, עם הנחיות בקבצים נפרדים ועם גרסאות | כשיש כמה תהליכים או צוותים, ורוצים לשנות הנחיה בלי פריסה חדשה |
| ניתוב מודלים | נקודת כניסה אחת לכל הקריאות, גם אם מאחוריה עומד מודל אחד | כשהעלות או זמן התגובה מצדיקים מודלים שונים למשימות שונות |
| נתונים והקשר | שמירת פעולות, מסמכים ותגובות משתמשים, עם הפרדה לפי לקוח | כשהנפח או הדרישות של לקוחות גדולים מחייבים אינדקס או מסד נתונים נפרד |
| בדיקות איכות | סט קטן של דוגמאות אמיתיות שרץ לפני כל שינוי | כשיש הרבה תהליכים, ומוסיפים לסט כל מקרה שנכשל בפרודקשן |
| עלות ומכסות | רישום עלות לכל קריאה ותקרה לכל תהליך | כשיש תוכניות מחיר שונות ולקוחות עם נפח גבוה |
מה נכנס ל-MVP
הטעות ההפוכה נפוצה לא פחות: לבנות פלטפורמת AI מלאה לפני שיש משתמש אחד. ב-MVP של מוצר AI-Native מספיק תהליך אחד שה-AI מבצע מקצה לקצה, טוב מספיק כדי שמשתמשים אמיתיים יסמכו עליו. סביבו בונים את המינימום: שמירת הנתונים והתגובות, נקודת כניסה אחת למודלים, סט בדיקות קטן ומדידת עלות. כל השאר מחכה לנתונים מהשטח.
זה גם מה שקובע את התקציב: כמה תהליכים יש במוצר, אילו אינטגרציות הוא צריך, אילו רכיבי AI יש בו ובאיזה קנה מידה הוא צריך לעבוד. טווחי מחירים ומה מזיז אותם תמצאו במדריך כמה עולה לפתח מערכת SaaS או מוצר דיגיטלי.
צ'קליסט לפני שמתחילים לבנות
- מה קורה למוצר אם מכבים את המודל?
- איזה תהליך אחד ה-AI יבצע מקצה לקצה כבר ב-MVP?
- איזה מידע נשמר כהקשר, ואיך הוא מופרד בין לקוחות?
- איפה המשתמש בודק, מתקן או מאשר את התוצאה?
- איך תדעו ששינוי בהנחיה או במודל לא קלקל תוצאות?
- כמה עולה תהליך אחד שהסתיים בהצלחה, ומה התקרה שלו?
- מי אחראי על איכות המודל אחרי ההשקה?
שאלות נפוצות
מה ההבדל בין מוצר AI-Native למוצר עם פיצ'ר AI?
במוצר עם פיצ'ר AI, ה-AI הוא קיצור דרך: אם מסירים אותו, המוצר עדיין עושה את העבודה. במוצר AI-Native המודל מבצע חלק מהפעולה המרכזית, ולכן הנתונים, הממשק והמדידה מתוכננים סביבו.
אפשר להפוך מוצר קיים ל-AI-Native?
כן, אבל לרוב לא בבת אחת. מתחילים מתהליך אחד שבו ה-AI יכול לבצע עבודה של המשתמש, בונים סביבו את שכבות הנתונים, הבדיקות והמדידה, ומרחיבים משם. ככל שהנתונים הקיימים מסודרים יותר, המעבר קל יותר.
צריך לבנות את כל חמש השכבות כבר ב-MVP?
לא. צריך גבולות ברורים ביניהן בקוד ותהליך אחד שעובד היטב. שירות תזמור נפרד, כמה מודלים ואינדקס נפרד לכל לקוח מגיעים כשהשימוש מצדיק אותם.
איזה מודל שפה כדאי לבחור?
אין תשובה אחת, והיא גם משתנה מהר. לכן חשוב שכל הקריאות יעברו דרך נקודה אחת, ושיהיה סט בדיקות שמאפשר להשוות מודלים על הנתונים שלכם. כך החלפת מודל היא החלטה מדודה ולא פרויקט. השוואה עדכנית של מחיר וביצועים תמצאו בעמוד מודלי שפה: מחיר, ביצועים ומה מדדנו.
זה רלוונטי גם לאפליקציות מובייל?
כן. באפליקציה נוספת השאלה מה רץ על המכשיר ומה בשרת: מודל על המכשיר מהיר יותר ושומר את המידע אצל המשתמש, ומודל בשרת חזק יותר ואפשר להחליף אותו בלי לשחרר גרסה חדשה לחנות. השכבות עצמן נשארות אותן שכבות.
מתכננים מוצר שה-AI נמצא בליבה שלו? בעמוד פיתוח מוצר דיגיטלי תמצאו איך אנחנו לוקחים מוצר מאפיון ל-MVP ועד SaaS, ובעמוד AI לעסקים את סוכני ה-AI והאוטומציות שאנחנו בונים. ספרו לנו על המוצר, ונעבור יחד על הארכיטקטורה לפני שכותבים קוד.