מערכת שירות לקוחות צריכה לקבל כמה החלטות עוד לפני שמישהו מנסח תשובה: מי יטפל בפנייה, עד כמה היא דחופה והאם צריך להעביר אותה לאדם. Jev AI, שהושק בגישה מוקדמת על ידי TypeSafe AI ב-15 בספטמבר 2026, נבנה להחלטות כאלה. ההשקה מציעה לצוותים אפשרות חדשה לבצע את ההכרעות הקטנות שחוזרות לאורך תהליך אוטומטי. להודעת ההשקה הרשמית.
במאמר נסקור את ההשקה, חמישה שימושים מעשיים ודרך לבחון שילוב ראשון במוצר. הסקירה מבוססת על תיעוד ציבורי ובדיקות שפורסמו; התהליכים שמופיעים בהמשך הם רעיונות ליישום, ולא תוצאות מהטמעה של DevShift.
Jev מול מודלי שפה: הביצועים בגרפים
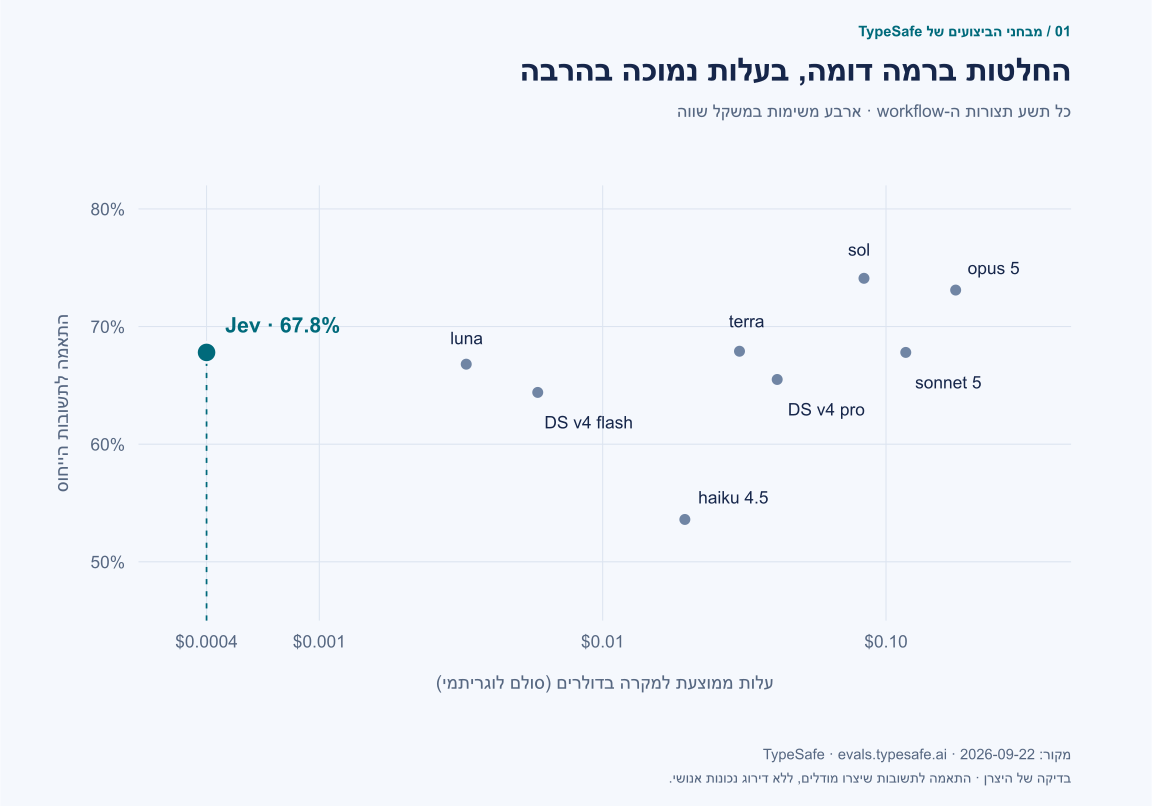
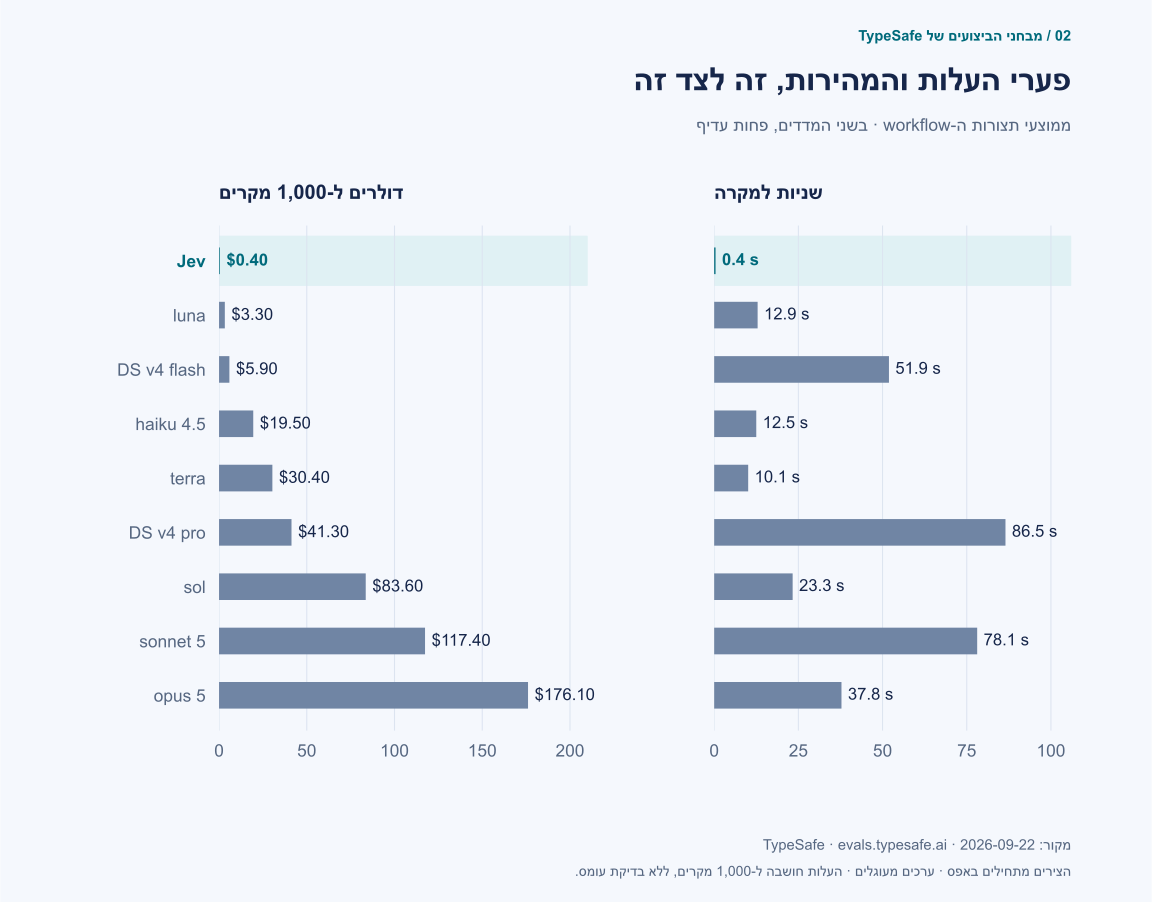
TypeSafe מדווחת על תוצאות מהירות עד פי 193.6 וזולות עד פי 444.6 בבדיקות התהליכים שלה. הגרפים הבאים מציגים את פערי העלות והמהירות לצד רמת הדיוק. אלה תוצאות של החברה, שמגדירה את המכפלות האלה כקצה הגבוה של השיפור שאפשר לצפות לו בשימוש מעשי. לשיטת הבדיקה בפוסט ההשקה.
לתשובות הייחוס
למקרה בתהליך
בחישוב ל-1,000 מקרים
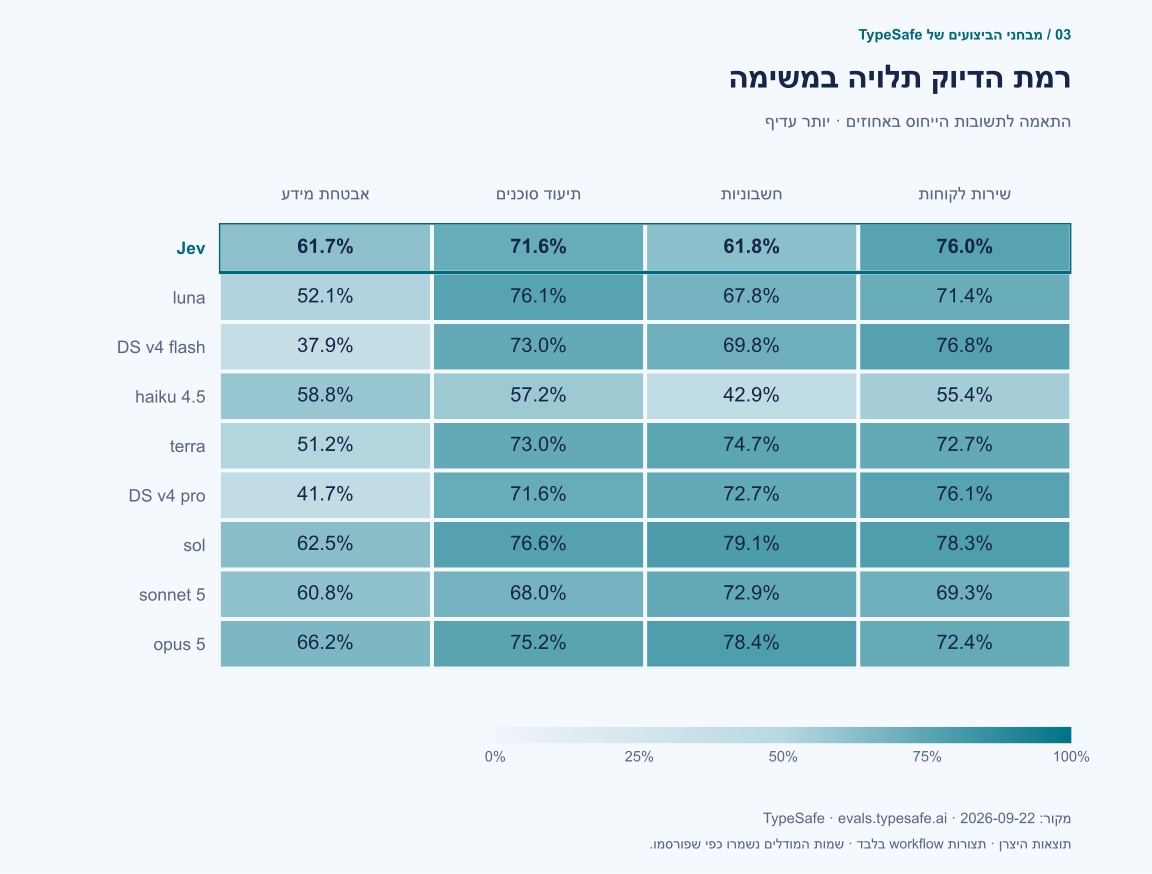
בסקירת הביצועים הרשמית ניתן משקל שווה לארבע משימות: אירועי אבטחה, בדיקת תיעוד של סוכנים, חשבוניות ושירות לקוחות. הגרפים כוללים את כל תשע תצורות ה-workflow, לפי הערכים המעוגלים ושמות המודלים שבאתר. ״דיוק״ כאן הוא התאמה לתשובות ייחוס של GPT-6 Astra ו-Claude Fable 5.1 ברמת חשיבה גבוהה; המודלים שנבדקו משתמשים בהגדרת החשיבה הרגילה של הספק.
לנתונים שמאחורי הגרפים
| מודל | התאמה לייחוס | דולרים למקרה | שניות למקרה |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4 |
| luna | 66.8% | $0.0033 | 12.9 |
| DS v4 flash | 64.4% | $0.0059 | 51.9 |
| haiku 4.5 | 53.6% | $0.0195 | 12.5 |
| terra | 67.9% | $0.0304 | 10.1 |
| DS v4 pro | 65.5% | $0.0413 | 86.5 |
| sol | 74.1% | $0.0836 | 23.3 |
| sonnet 5 | 67.8% | $0.1174 | 78.1 |
| opus 5 | 73.1% | $0.1761 | 37.8 |
| מודל | אבטחת מידע | תיעוד סוכנים | חשבוניות | שירות לקוחות |
|---|---|---|---|---|
| Jev | 61.7% | 71.6% | 61.8% | 76.0% |
| luna | 52.1% | 76.1% | 67.8% | 71.4% |
| DS v4 flash | 37.9% | 73.0% | 69.8% | 76.8% |
| haiku 4.5 | 58.8% | 57.2% | 42.9% | 55.4% |
| terra | 51.2% | 73.0% | 74.7% | 72.7% |
| DS v4 pro | 41.7% | 71.6% | 72.7% | 76.1% |
| sol | 62.5% | 76.6% | 79.1% | 78.3% |
| sonnet 5 | 60.8% | 68.0% | 72.9% | 69.3% |
| opus 5 | 66.2% | 75.2% | 78.4% | 72.4% |
מה זה אומר בפועל: Jev משווה את התוצאה הממוצעת של sonnet 5, עם 67.8% התאמה לייחוס, בעוד sol מגיע ל-74.1%. הפירוט לפי משימה חשוב: Jev משיג 76.0% בשירות לקוחות, אבל 61.8% בחשבוניות. לדעתנו, סיווג וניתוב שחוזרים בתדירות גבוהה הם מועמדים טובים לפיילוט; שיעור הטעויות בתהליך עצמו יקבע אם החיסכון משתלם.
כדאי לקרוא את הנתונים בהקשר. הבדיקות נערכו על ידי היצרן. מעטפת מודלי השפה מחזירה גם הסתברויות, ולפי TypeSafe היא עשויה להיות איטית ויקרה יותר מהחזרת החלטה בלבד. מכפלות המהירות והחיסכון שפורסמו מבוססות על נתוני הבדיקה המקוריים; אי אפשר לשחזר אותן במדויק מהערכים המעוגלים שבגרפים.
יש גם בדיקה חיצונית ראשונית. LangChain בחנה חמש תשובות קבועות של סוכן מזג אוויר, עם 100 חזרות על ההערכה בכל מקרה. Jev הגיע לממוצע של 0.44 שניות ולעלות של $0.00035 לקריאה, והתאים להחלטת הבודק האנושי בכל 500 ההכרעות הבינאריות החוזרות. זה ממצא מעודד למשימה המצומצמת שנבדקה. חמש תשובות שונות אינן מספיקות כדי להסיק על דיוק בתהליכים עסקיים אחרים.
נכון לבדיקה ב-22 בספטמבר, TypeSafe מציגה מחיר של $0.042 למיליון טוקני קלט ב-Jev 1.13, ללא תשלום על טוקני פלט. זהו מחיר ה-API הישיר; יש לבדוק את מסלול הגישה שבו משתמשים בפועל. בתקציב הפרויקט צריך לכלול גם חיפוש, יצירת תשובות, ניסיונות חוזרים, בדיקה אנושית ואינטגרציה. לפרטי המודל והתמחור.
מה Jev AI מוסיף למערכת תוכנה
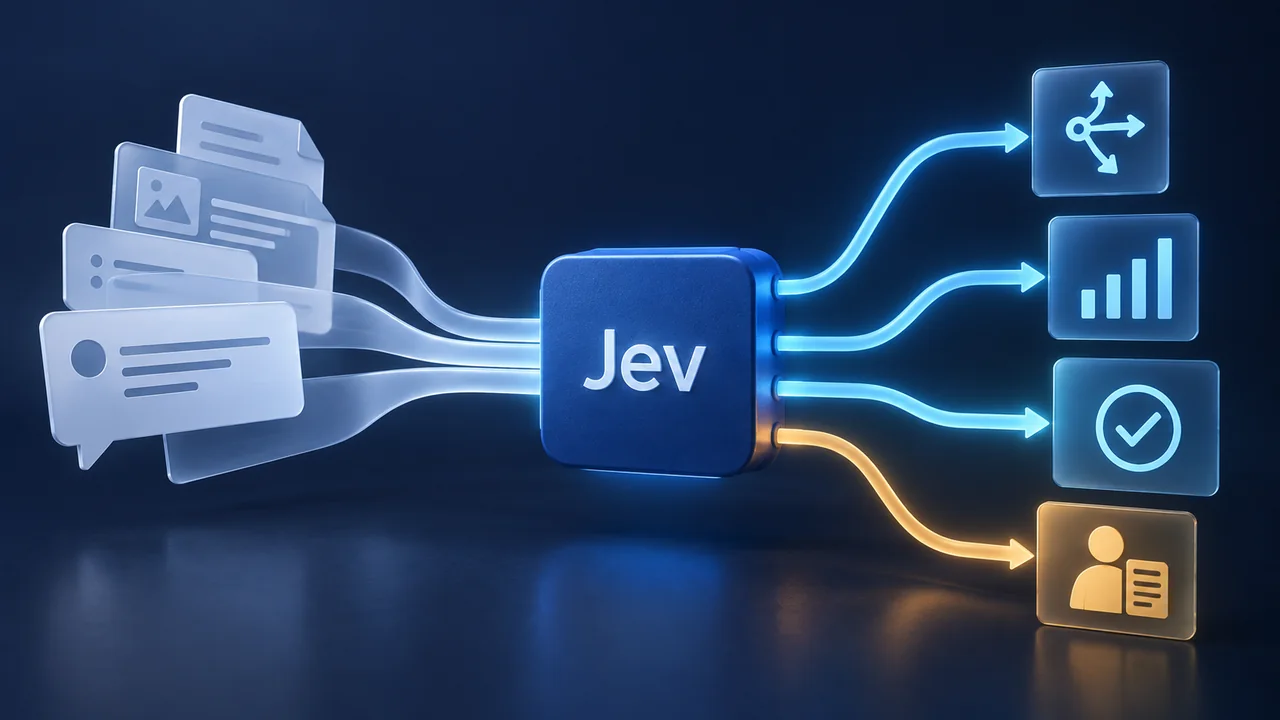
TypeSafe מגדירה את Jev כמודל System One: מעבירים לו הקשר, שנקרא state, ומגדירים את השאלות שהתוכנה צריכה לענות עליהן. Jev מחזיר תוצאות מטיפוסים מוגדרים, שהמערכת יכולה להשתמש בהן כדי לבחור מסלול טיפול או להעביר מקרה לבדיקה. החברה מכנה את שיטת האימון שלה RLCD, למידת חיזוק להחלטות מכוילות, שנועדה להפיק הערכות הסתברות שימושיות לאוטומציה. המבוא של TypeSafe מסביר את הממשק.
ה-API תומך בשלושה סוגי שאלות:
- Choice: בחירה מתוך אפשרויות שהוגדרו מראש, למשל חיובים, תמיכה טכנית או מכירות. התוצאה כוללת את האפשרות שנבחרה, התפלגות הסתברויות ומדד ביטחון.
- Score: הערכה לפי סולם מסודר, למשל רמת התסכול של לקוח. מתקבלים ציון מספרי, הסתברויות לרמות השונות ומדד ביטחון.
- Noul: הערכת ההסתברות שטענה של כן או לא נכונה. מתקבל מספר בין 0 ל-1, ולא ערך בוליאני או שדה ביטחון נפרד.
אפשר לבדוק כמה שאלות באופן עצמאי מול אותו הקשר בקריאה אחת. אם החלטה אחת תלויה באחרת, האפליקציה עדיין צריכה לשלב את התוצאות או לבצע קריאה נוספת. החלוקה ברורה: המודל מפרש את המידע, והקוד קובע מה יקרה בעקבות התשובה.
ב-16 בספטמבר Vercel הוסיפה את Jev ל-AI Gateway. למחרת פרסמה LangChain מדריך אינטגרציה, וב-21 בספטמבר LangSmith הוסיפה את Jev כשופט להערכת סוכנים. החיבורים האלה מאפשרים לבחון אותו בתוך סביבת סוכנים קיימת.
חמישה שימושים מעשיים ב-Jev AI
1. ניתוב פניות שירות והודעות נכנסות
פרויקט ראשון שימושי הוא שיוך פניות לצוות המתאים. שואלים בנפרד על נושא הפנייה, הדחיפות שלה והאם יש מספיק מידע כדי להתקדם. גם מדריך ההתחלה של TypeSafe משתמש במיון פניות כדי להדגים את שלושת סוגי השאלות.
למשל, תלונה על חיוב כפול יכולה לעבור לצוות החיובים, ודיווח חלקי על תקלה בחיבור למערכת אחרת יכול לעבור לתמיכה לבירור. בתחילת הדרך כדאי להציג הצעת ניתוב בלבד. מודדים כמה שיוכים תוקנו וכמה פניות דחופות הוחמצו, ורק אז שוקלים פעולה אוטומטית. Jev מספק את הסיווג; אדם או מודל גנרטיבי עדיין יכולים לנסח את התשובה.
2. בחירת המודל או הסוכן המתאים למשימה
חיפוש פרט על מוצר וחקירה של באג מורכב דורשים משאבים שונים. Jev יכול לסווג את הבקשה ולבחור מתוך מסלולי טיפול שהוגדרו מראש. LangChain מדגימה ניתוב בין מודלים ובדיקת סיכון בפעולות כלים באינטגרציה שלה.
נקודת פתיחה טובה בעינינו היא מספר קטן של מסלולים, עם תחומי אחריות ברורים ומסלול חלופי למקרה של ספק. משווים את העלות הכוללת ואת שיעור השלמת המשימות לתהליך הקיים. החלטת ניתוב זולה לא תועיל אם היא שולחת שוב ושוב עבודה מורכבת למודל שנאלץ לנסות מחדש.
3. בדיקת פעולות שסוכן מתכנן לבצע
לפני שסוכן מריץ פקודה, מודל סיווג יכול לסמן כתיבה, מחיקה או פעולה שחורגת מהבקשה המקורית. מנגנון Auto Mode הניסיוני של LangChain מדגים שילוב של Jev לפני הפעלת כלי.
התוצאה צריכה לשמש אות נוסף לבקרה. הרשאות, פעולות מותרות ואישורים נדרשים צריכים להישאר באחריות האפליקציה. סיווג תקין לא אמור להעניק לסוכן גישה שלא הייתה לו קודם. בפיילוט אפשר להשוות את הסימונים של Jev להחלטות הבודקים, תוך שמירה על מנגנוני הבקרה הקיימים.
4. סינון מסמכים לפני יצירת תשובה
עוזר ידע עשוי למצוא קטעי טקסט שמזכירים את הנושא הנכון, אבל לא עונים על השאלה. TypeSafe פרסמה דוגמה לסיווג קטעים שנשלפו בחיפוש, לפני שמעבירים אותם למודל שמנסח את התשובה.
עוזר רכש יכול להשתמש במבנה הזה כדי להפריד בין תנאי ספק רלוונטיים לבין טקסט כללי, ולסמן מידע סותר לבדיקה. כדאי לשמור את ההפניות למקורות לצד התוצאות, כדי שאפשר יהיה לבדוק אותן. הקלט הנוכחי של Jev הוא טקסט; מסמכים סרוקים צריכים לעבור קודם OCR או חילוץ מידע אחר. זהו שלב אפשרי בתוך תהליך רחב יותר של ניתוח מסמכים.
5. הערכת תשובות של סוכני AI
גם בקרת איכות מורכבת משאלות מוגדרות: האם התשובה התייחסה לבקשה, האם נשמר המבנה הנדרש והאם נותר עניין חשוב ללא מענה. התמיכה של LangSmith ב-Jev מאפשרת לשמור הערכות כאלה כמשוב מובנה על ריצות של סוכנים.
כדאי להתחיל מקריטריונים שבודקים אנושיים יכולים לתייג באופן עקבי. משווים את ההערכות של Jev לתיוגים ובודקים את המחלוקות. בדיקות מדויקות, כמו קיומו של שדה חובה, נשארות בקוד. כשצריך גם נימוק כתוב להערכה, מודל גנרטיבי יכול להתאים יותר.
פלט תקין עדיין יכול להיות החלטה שגויה
התאמה לסכמה אינה הוכחה לנכונות. בחירה ב״חיובים״ מתוך רשימה מונעת המצאה של מחלקה שלא קיימת. היא לא מוכיחה שצוות החיובים הוא הכתובת המתאימה.
במגבלות שפרסמה TypeSafe עבור Jev 1.13 מופיעות חולשות בחישובים ובהשוואת תאריכים, רגישות למידע לא רלוונטי ופגיעות לטקסט שנועד להטעות את המודל. לכן חישובים ולוגיקת תאריכים נשארים בקוד, ההקשר צריך להיות ממוקד, ובדיקות צריכות לכלול גם קלט מטעה. Jev גם אינו מייצר את האימייל, ההסבר או הדוח הסופי.
חשוב להבחין בין הסתברות לבין מדד ביטחון. ב-Choice וב-Score, הביטחון נגזר מההתפלגות בין התשובות; הוא אינו ערובה נפרדת לנכונות. את ספי הפעולה קובעים לפי ביצועים שנמדדו ולפי המחיר של טעות. מדריך הביטחון של TypeSafe מתאר כיצד להעביר תוצאות לא ודאיות לבדיקה.
לפי TypeSafe, הדיוק הגבוה ביותר מתקבל באנגלית. עברית וקלט שמשלב שפות דורשים בדיקה נפרדת. כדאי לקבע את גרסת המודל ששימשה לאימות ספי הפעולה: הכינוי jev-latest יכול להתעדכן. להערות על שפות וגרסאות.
איך היינו מתחילים פיילוט עם Jev
בוחרים החלטה שחוזרת בתדירות גבוהה, גוזלת זמן ואפשר לתקן אותה. קל יותר להעריך ניתוב פניות או רלוונטיות של מסמך מאשר בקשה כללית ״להפוך את שירות הלקוחות לאוטומטי״. כך היינו מתקדמים:
- אוספים מדגם מתויג. כוללים מקרים רגילים, מידע חסר, בקשות עמומות ודוגמאות בכל שפה שהמוצר משרת. שומרים קבוצת מקרים נפרדת לבדיקה הסופית.
- מגדירים את ההחלטה. כותבים אפשרויות וקריטריונים ברורים. מוסיפים דרך לטפל בחוסר ראיות, וקובעים מה האפליקציה תעשה כשאין ודאות מספקת.
- מריצים לצד התהליך הקיים. מתעדים הצעות בלי לבצע אותן. משווים טעויות, זמני תגובה, היקף בדיקה אנושית ועלות כוללת לתהליך הנוכחי.
- מפעילים מסלול אוטומטי מוגבל. מאפשרים רק פעולות שהבדיקה הצדיקה. שומרים מסלול חלופי לתשובות לא ודאיות ולתקלות API, ובודקים שוב אחרי שינוי גרסת המודל.
ההשקה מציעה אפשרות שכדאי לבחון: מודל ייעודי להכרעות חוזרות בתוך מערכת רחבה יותר. ההצלחה נמדדת בפחות טעויות יקרות ובפחות עבודה מיותרת לאורך התהליך כולו. לצוותים שבוחנים שילוב כזה, שירותי פיתוח ה-AI שלנו כוללים את בניית התהליך והאינטגרציה סביב המודל. דברו איתנו על הפרויקט שלכם.
המקורות והזמינות נבדקו ב-22 בספטמבר 2026. מחירים, אינטגרציות והתנהגות המודל עשויים להשתנות. DevShift לא ערכה בדיקת ביצועים עצמאית ל-Jev לצורך המאמר.